Administración de Oracle 11g – Arquitectura de la Base de datos (parte3)

En este capitulo nos vamos a centrar en aprender las estructuras de memoria que maneja el servidor Oracle.

En la diapositiva podemos ver 2 estructuras de memoria dentro del servidor.arquitectura_base_de_datos_oracle2
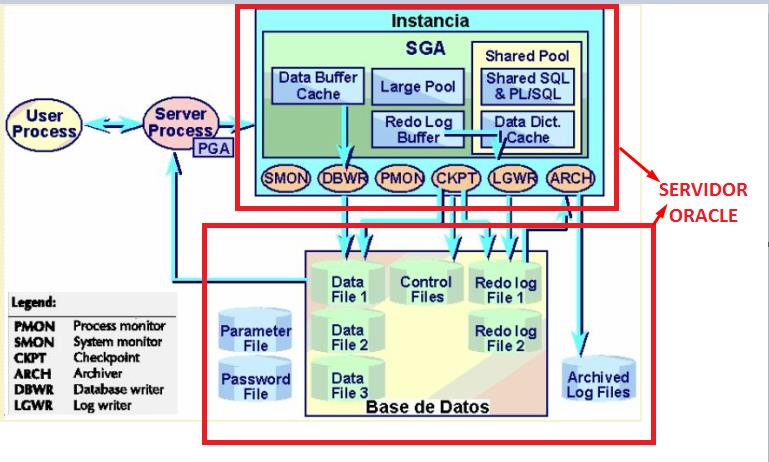
  • La SGA (System Global Area) es la caché de nuestra instancia donde se cacheaban nuestras sentencias y los datos devueltos. Esta memoria es compartida por todos los procesos.
  • La  PGA (Program Global Area) es la zona de memoria privada de cada proceso Oracle (también para los procesos background), donde la información que contiene básicamente información sobre la sesión (que usuario esta conectado, privilegios,  que cursores están abiertos, buffer de ordenación ). Los procesos background tienen también su propia PGA
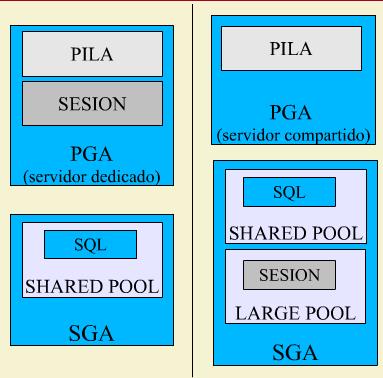
Memoria SGA y PGA

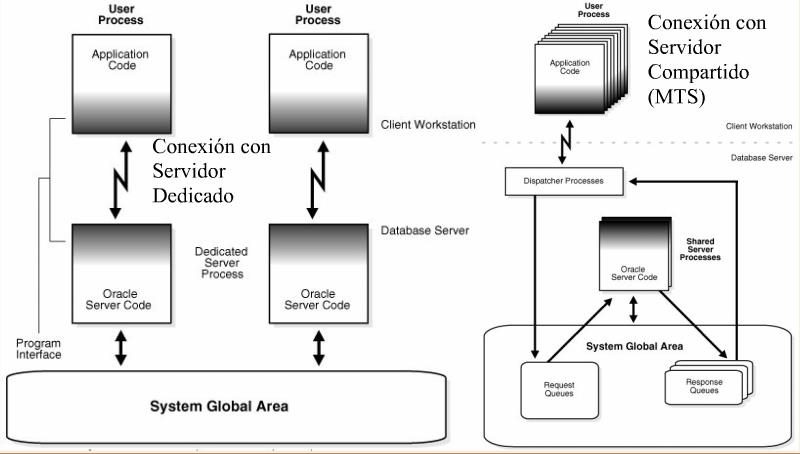
En la diapositiva superior podemos ver en la parte izquierda la estructura de un servidor dedicado y en la parte derecha un servidor compartido.

Podéis observar que en la parte izquierda (servidor dedicado) la SGA (estructura de memoria compartida que proporciona la instancia)  y para cada servidor dedicado tendremos su PGA (la sesión y la pila).

Si os dais cuenta que en el modelo de la izquierda (servidor dedicado) se desperdicia memoria ya que en la PGA se guarda un buffer de short area (que es utilizado para las ordenadores), pero ¿Qué pasa si esa sesión no hace ninguna ordenación? es memoria que se esta desperdiciando.

Para solucionar esto, Oracle a partir de la 9i introduce un concepto llamado PGA_AGGREGATE_TARGET, esto permite definir un espacio compartido parecido a la SGA para las PGAs.
En lugar de tener un buffer de ordenación (sort area) dentro del proceso de la PGA, estará dentro de un pool compartido, evitando la necesidad de asignar parámetros como SORT_AREA_SIZE o HASH_AREA_SIZE a las memorias privadas de la PGA.

El valor mínimo de el PAGA_AGGREGATE_TARGET es 10 M.
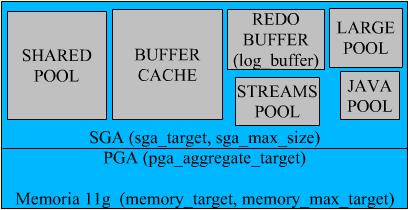
PGA_AGGREGATE_TARJET

¿Cómo configurar la memoria de Oracle?

Con Oracle 11g se configura la memoria del Servidor (SGA + PGA) con un sólo parámetro llamado MEMORY_TARGET.

En Oracle 11g solo hay que configurar el memory_target y memory_max_target.
En el memory target asignaremos el 80% de la memoria ram (como recomienda oracle)
El memory_max_target es la memoria maxima que puede utilizar, esto es utilizado ya que reserva la memoria RAM.

  • MEMORY_TARGET dimensiona SGA + PGA. Puede crecer manualmente hasta MEMORY_MAX_TARGET.
  • sga_tarjet, sga_max_size pga_aggregate_target se pueden dejar a cero (sga_max_size, por defecto, sería el 60% de memory_target), o con un valor mínimo.
  • En Linux, memory_target y memory_max_size están limitados por el valor de /dev/shm, para cada ua de las instancias que haya en el servidor: si /dev/shm vale 2Gb, entonces ninguno de ellos pueden valer más de 2Gb para cada instancia del servidor.
  • También hay que configurar el Bugger de Redo con log_buffer (igual que en 10g y versiones anteriores).
  • V$MEMORY_DYNAMIC_COMPONENTS: tamaños actuales.
  • V$MEMORY_TARGET_ADVICE: recomdaciones de MEMORY_TARGET.
  • V$MEMORY_RESIZE_OPSS: operaciones de AMM.

Recomendaciones de Oracle

  • Oracle recomienda asignar un máximo del 80% de la RAM de la máquina para el Servidor Oracle.
  • A su vez, de dicho 80%, recomienda asignar un máximo del 20% para la SGA


Administración de Oracle 11g – Tema 2 (Ficheros de inicialización: init.ora y spfile.ora)

Hoy vamos a ver todo lo que tiene que ver con el arranque y la parada de la base de datos, para ello vamos a ver primero el fichero de configuración de la instancia.

Para arrancar la instancia, el servidor Oracle tiene que leer el fichero de parámetros de inicialización (spfile o init), cuya ubicación predeterminada es $ORACLE_HOME/dbs.

El fichero de parámetros de inicialización puede ser de dos tipos

  • Init: se trata de un fichero de texto, editable, cuyo nombre sigue el patron init$ORACLE_SID.ora
  • Spfile: es un fichero binario, no editable pero visualizable, cuyo nombre sigue el patrón spfiles$ORACLE_SID.ora.
    • Para poder crear un fichero binario (Spfile) es necesario crear un  crear un fichero ascii, por tanto hay que partir de un fichero init.
      La primera vez que arrancamos la base de datos oracle lo hacemos con el fichero init, y luego ya creamos el Spfile.
      CREATE SPFILE [=’nombre’] FROM PFILE [=’nombre’];
      Si se omiten los nombres, toma los valores por defecto.
      La Base de datos no podrá abrir el nuevo spfile hasta el siguiente arranque.
      Se puede crear un init a partir de un spfile, invirtiendo la sixtansis.
    • Los parámetros del spfile se modifican con:
      ALTER SYSTEM SET parametro = valor [SCOPE = MEMORY | SPFILE | BOTH]Si sólo queremos modificar el parámetros en el spfile, indicaremos SPFILE. Para hacer el cambio solo en memoria, especifica MEMORY.

Oracle cuando arranca primero comprueba si existe el fichero Spfile, si este no existe buscara el fichero Init y arranca con este.

¿Por qué la base de datos Oracle busca primero el fichero Init?

El fichero binario te proporciona mayor seguridad a la hora de configurar la base de datos Oracle porque te parsea los parámetros, por tanto si metes un parámetros que no existe o un valor que se sale del rango te dirá oracle donde esta el error cosa que con el texto plano solo te indicará que existe un error en el fichero pero no te indica el motivo.

¿Cómo se crea un fichero Init?

  •  Hay dos tipos de parámetros:
    • Explícitos: los que se indican en el fichero de parámetros.
    • Implícitos: el resto, que tomarán un valor por defecto.
  • La forma de indicar valor a los parámetros es
    parametro=valor.
  • El símbolo # indica el comienzo de un comentario, pudiendoestar al principio o en medio de la línea.
  • En el init.ora, el parámetro ifile permite incluir otros ficheros con parámetros.
  • Una lista de valores se indicará entre paréntesis, separando los valores por comas.
  • Para indicar un valor de tipo cadena de caracteres hay que encerrarlo entre comillas simples.
  • Si usamos OFA, la ubicación típica para el init.ora es $ORACLE_BASE/admin/$ORACLE_SID/pfile. Después creamos unenlace en $ORACLE_HOME/dbs (ubicación por defecto).

Ejemplo de código INIT.ORA

db_name=CURSO08
db_block_size=2048
compatible = 11.1.0
control_files = (/u02/oradata/CURSO08/control1.ctl,
/u03/oradata/CURSO08/control2.ctl)
undo_management = auto # Utilizado para realizar rollback de las transacciones
undo_tablespace = undo_rbs 
diagnostic_dest = /u01/app/oracle # Parámetro que define donde va estar el directorio de diagnostico.
memory_max_target = 208M
memory_target = 200M
sga_max_size = 160M
sga_target = 0
pga_aggregate_target = 0
log_buffer = 1048576
log_checkpoint_interval = 0
log_checkpoint_timeout = 1800 # t. en segundos
processes = 40 # Establece el nº max procesos simultaneos en la instancia, (procesos background + procesos servidores)
remote_login_passwordfile=EXCLUSIVE # Para activar el fichero de claves para usar el sys en remoto.
nls_territory=spain
nls_language=spanish
session_cached_cursors=50 # En <=9i era open_cursors (Numero de cursores que se van a cachear en la sesion)
result_cache_max_size = 8M


Instalar Oracle SQL Developer

Vamos a ver como instalar de forma rápida el SQL Developer en entorno Windows.

SQL Developer en un programa que no requiere de instalación, se descomprime, se ejecuta y se utiliza.

El SQL Developer solo requiere del SDK de java, en el caso caso del SQL Developer 4.0 requiere como mínimo el JDK 7.

Veamos los pasos para instalar el SQL Developer

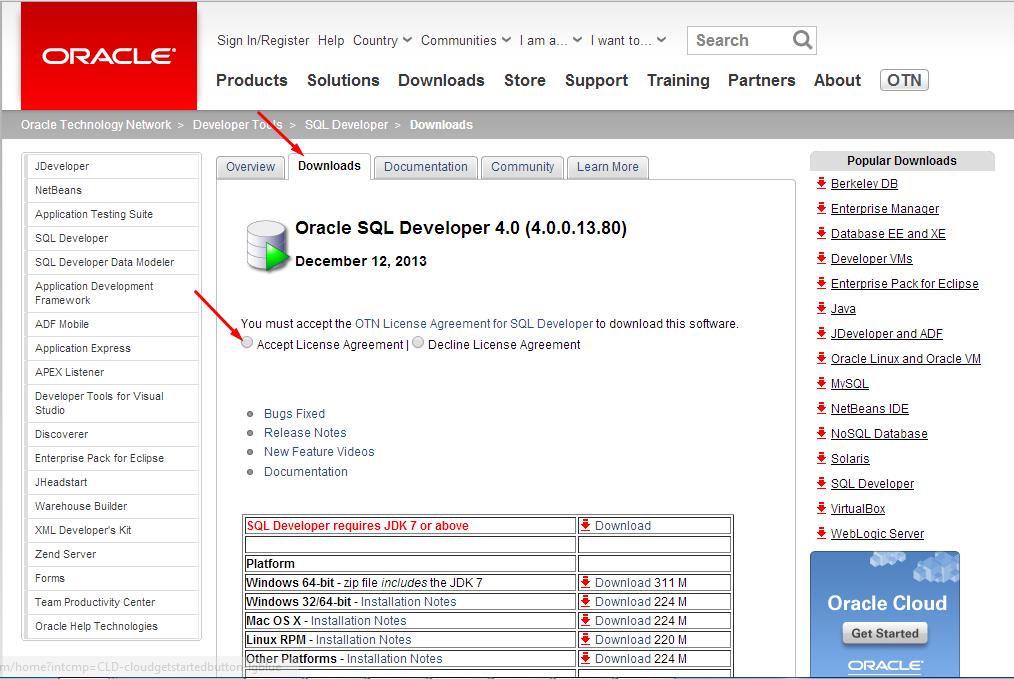
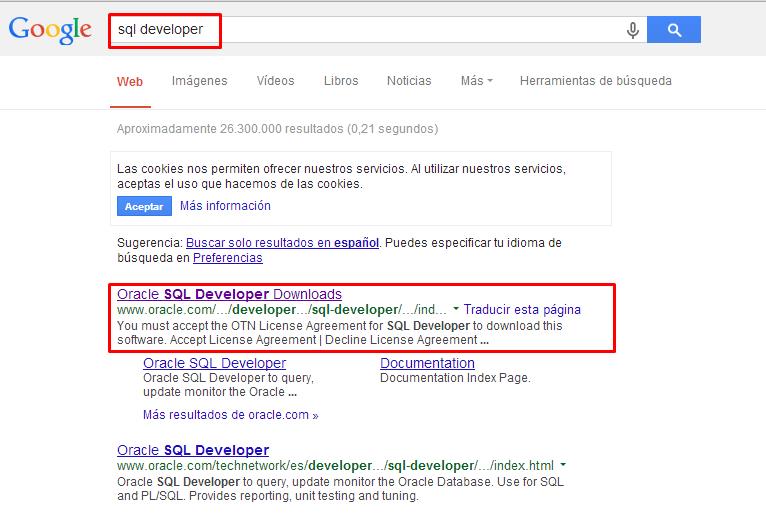
    1. Abrimos nuestro amigo www.google.es y escribimos «SQL Developer» Pulsamos en la primera entrada que nos aparezca (cerciórate que el el domino sea www.oracle.com) SQL Developer instalacion1
    2. Pulsamos en «Download», Aceptamos los términos y nos descargamos la versión que mas no interese (Windows 32 bits o 64 bits).

SQL Developer instalacion2

Ahora nos vamos a descargar el JDK de java, para ello seguimos los siguientes pasos

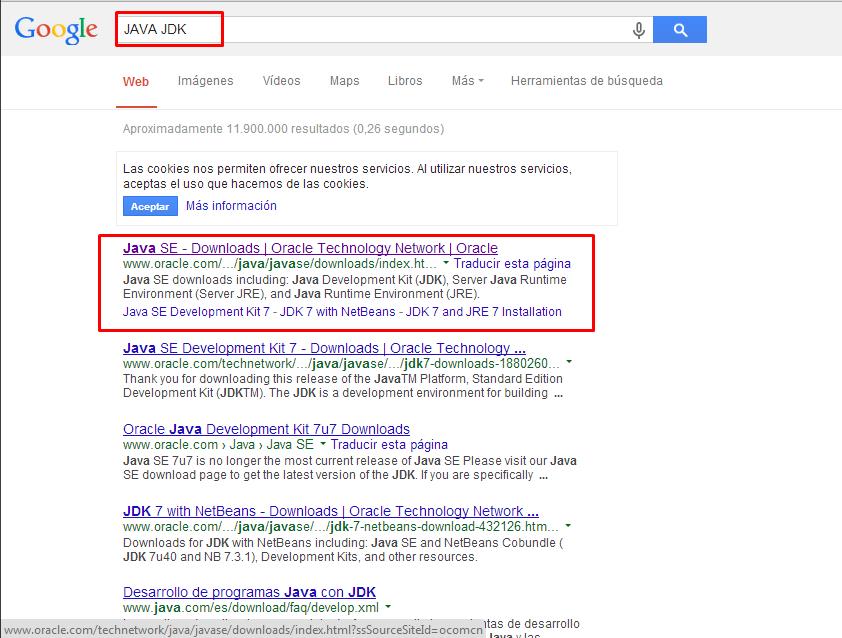
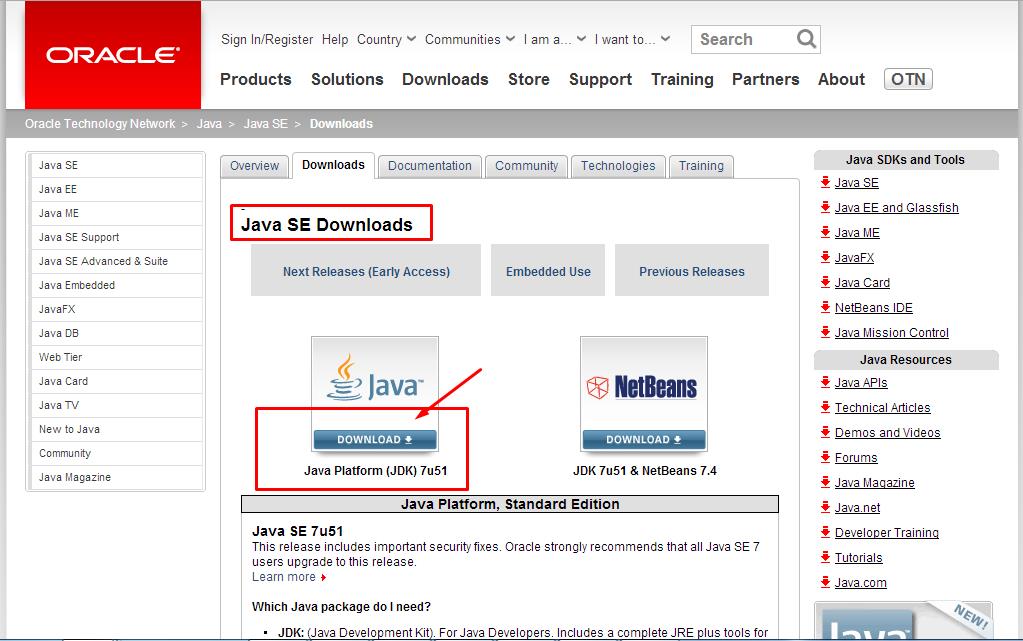
    1. Abrimos www.google.es y escribimos «JAVA JDK» Pulsamos en la primera entrada que nos aparezca (cerciórate que el el domino sea www.oracle.com)

SQL Developer instalacion3
SQL Developer instalacion4

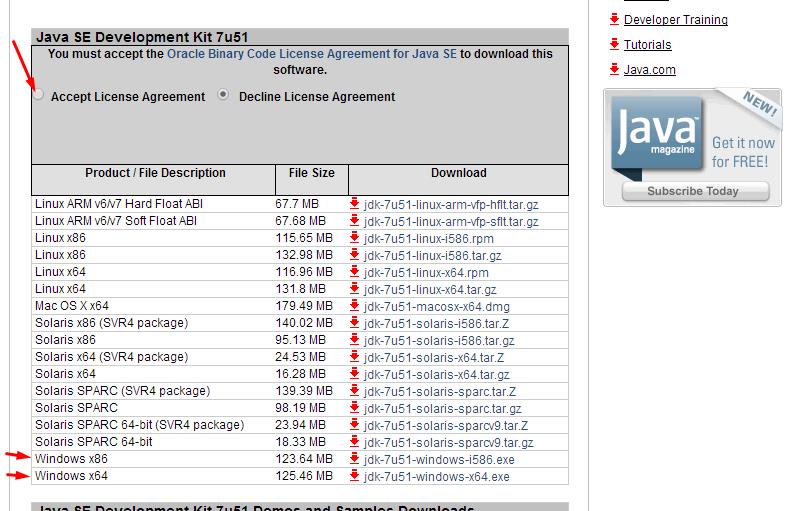
    1. Aceptamos la licencia y nos descargamos la versión que mas nos interese

SQL Developer instalacion5

Una vez que tengamos los dos ficheros descargados instalamos el JDK, no voy a poner pantallazos porque es muy sencillo instalarlo.

Una vez instalado el JDK descomprimimos el SQL Developer.

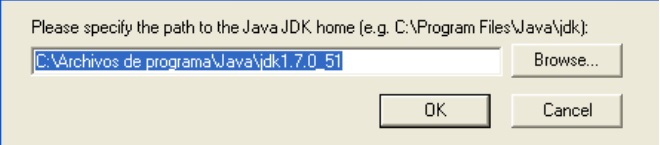
Lo ejecutamos y nos saldrá una ventanita como esta para que le indiquemos donde esta el JDK de java si no lo ha encontrado el automáticamente.

SQL Developer instalacion6

Una vez puesto el path del Java JDK el programa SQL Developer arrancará.

Administración de Oracle 11g – Arquitectura de la Base de datos (parte2)

En este capitulo nos vamos a centrar en como nos conectamos a una base de datos de Oracle y que tipo de conexiónes podemos hacer hacia una base de datos, por último veremos como conectarnos a través del SQL Developer a un servidor Oracle.

  • Para poder conectarnos a una Base de Datos Oracle, necesitamos una serie de variables en el entorno del usuario del Sistema Operativo desde el que realizaremos la conexión.

En el caso de unix/linux:

    • ORACLE_HOME : Contiene el directorio donde esta el software de Oracle instalado.
    • ORACLE_SID: Es el nombre de nuestra base de datos o mejor dicho, el identificador de la instancia Oracle.
    • PATH: $PATH:$ORACLE_HOME/bin .
    • LD_LIBRARY_PATH=$ORACLE_HOME/lib. Localización de las librerías compartidas (Linux /Unix)
    • NLS_LANG=spanish_spain. Idioma del cliente (opcional)
  • Proceso de usuari: La ejecución de la aplicación que permite al usuario iniciar la conexión. Por ejemplo cuando un usuario se conecta con el sql*plus
  • Proceso servidor: se crea en el SBD cuando el usuario se conecta a la base de datos, y es el que realmente interactúa con la base de datos.
  • Una conexión de un proceso de usuario a la al SBD es una sesión en la base de datos (puede haber varias del mismo usuario) que se inician cuando el usuario se valida contra la base de datos y termina al desconectarse.
  • Desconectar una sesión de un usuario podemos hacerlo de la siguiente manera
    «ALTER SYSTEM DISCONNECT SESSION ‘sid, serial#’;
    existen opciones para la desconexión, por ejemplo [POST_TRANSACTION] espera que termina de escribir en base de datos y una vez finalizado finaliza la sesión y el  [IMMEDIATE] finaliza la sesión inmediatamente, si al eliminar la sesión esta metiendo datos, se haría rollback de los datos.
    Desconectar destruye la conexión con el servidor dedicado ( o el circuito virtual si MTS).

conexion base de datos oracle

En nuestro base de datos por norma general tendremos tantas sesiones como clientes estén conectados, conforme estos salen y entran se crearán o eliminaran sesiones.
Se crea un proceso por cada sesión que se establezca en base de datos.

Para que una base de datos Oracle funcione adecuadamente hay que proporcionar a nuestro hardware suficientes recursos para que pueda trabajar.

Por ejemplo:

  • La instancia contiene luna SGA y esa SGA consume memoria RAM, por tanto necesitamos saber cuanta memoria RAM necesitamos asignarle para que la base de datos funcione bien.
  • El Número de sesiones simultaneas que se ejecutan (vamos suponer que consumen cada proceso/sesión unos 10 megabytes). Si hay 10 usuarios conectados necesitamos 100 megabytes, si hay 100 , necesitaremos 1000 megabytes.

Podemos hacer dos cosas o limitar el numero máximo de procesos que se pueden ejecutar en esa instancia o tener suficiente memoria RAM para que todos clientes puedan ejecutarse al mismo tiempo.

Otra solución es a través de una conexión con Servidor compartido (MTS) con un sistema de Dispatcher, el Dispacher se encarga de recibir las peticiones de los usuarios y el Dispacher por medio de una cola va tratando cada petición.

La ventaja del servidor compartido es que nuestra base de datos requerirá de menos recursos de nuestro hardware.
El inconveniente es que el servidor compartido ralentiza las peticiones a la base de datos debido a que las peticiones están encoladas.

También es posible simultanear los dos tipos de conexiones, por ejemplo nuestras peticiones que se realicen a través de nuestra página web se realicen a través de un servidor compartido, y la aplicación  de nuestra secretaria sea a través de una conexión con servidor dedicado.

Vale, ya tenemos un poco de teoría, ahora vamos a ver como creamos una conexión para la base de datos, para ello vamos a utilizar el SQL Developer.

SQL Developer

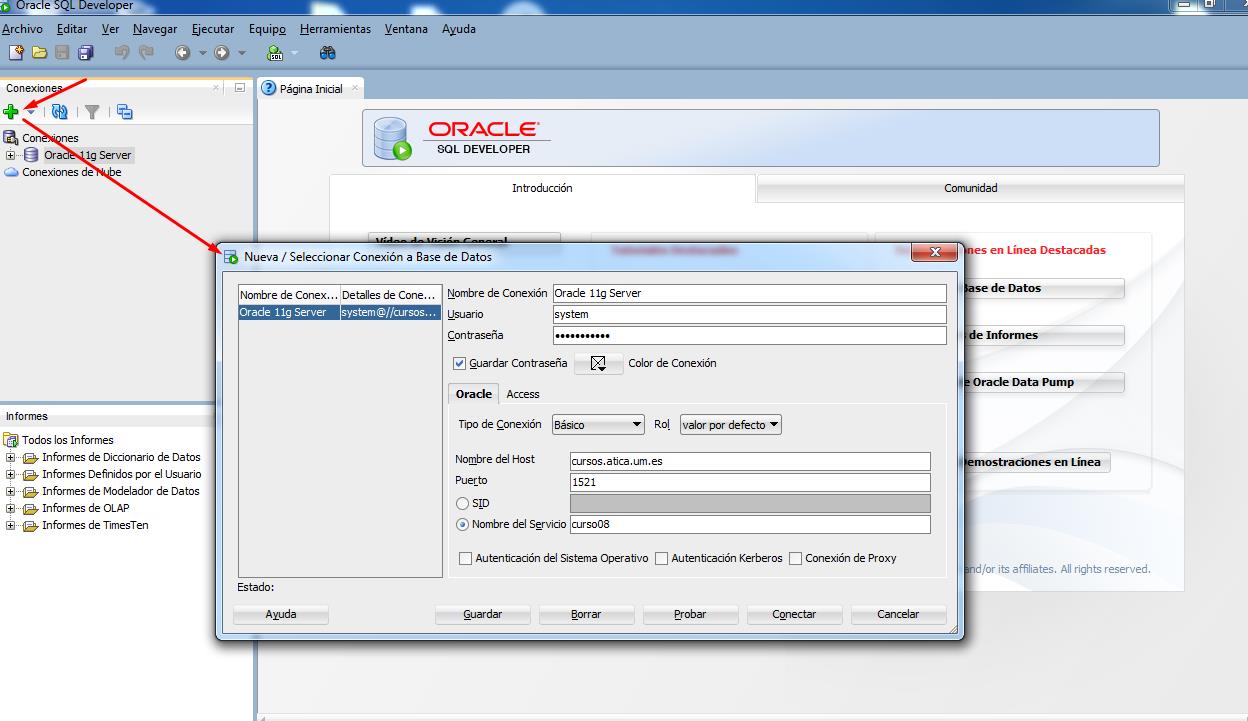
  • Abrimos nuestra aplicación SQL Developer.
  • Pulsamos en el boton + (en color verde).
  • Rellenamos los datos de conexión
    • Nombre de la Conexion: Nombre para identificar nuestra conexión a la base de datos, por si tuvieramos muchas base de datos para que la podamos identificar facilmente.
    • Usuario: Usuario de la base de datos.
    • Contraseña: Contraseña de la base de datos
    • Nombre del Host: La dirección ip o dominio de nuestro host donde esta nuestra BD
    • Puerto: Es el puerto donde escucha nuestra BBDD por defecto es el 1521
    • Nombre del Servicio: El nombre de del servicio de nuestra DB
  • Pulsamos en «Probar» y comprobamos que en Estado aparece «Estado: Correcto»
  • Pulsa «Guardar» para guardar la configuración y no tenerla que meter cada vez que abres el SQL Developer.
  • Por último pulsamos en «Conectar».

SQL Developer_conexion

Una vez conectado nos debe aparecer nuestra conexión con la base de datos en la parte izquierda del SQL Developer.

SQL Developer_conexion_establecida

Administración de Oracle 11g – Arquitectura de la Base de datos (parte1)

En esta primera parte vamos a ver que es una Base de Datos Oracle, de que se compone, y definiremos la Instancia.

Un servidor Oracle es una Instancia más una base de datos.

La Instancia esta formada por la SGA mas procesos en background.

La SGA (Área Global del Sistema) es una estructura básica de memoria ( es una gran cache ) donde Oracle cachea toda la información que maneja, tanto los datos de las tablas como las sentencias SQL que ejecutamos contra el servidor de Oracle. Los datos recuperados de las consultas SQL ejecutadas también son cacheadas por la SGA.

Los procesos en background:

  • SMON (System Monitor): Es el supervisor del sistema y se encarga de todas las recuperaciones que sean necesarias durante el arranque.
  • DBWR (Database Writer): El proceso DBWR es el responsable de gestionar el contenido de los buffers de datos y del caché del diccionario.
  • PMON (Process Monitor):Este proceso restaura las transacciones no validadas de los procesos de usuario que abortan, liberando los bloqueos y los recursos de la SGA.
  • CKPT (Checkpoint):Este proceso escribe en los ficheros de control los checkpoints. Estos puntos de sincronización son referencias al estado coherente de todos los ficheros de la BD en un instante determinado, en un punto de sincronización.
  • LGWR (Log Writer):  Este proceso es que se encarga de escribir el contenido de los buffers del redo log en el disco.
  • ARCH (Proceso archivador): El proceso archivador tiene que ver con los ficheros redo log. Por defecto, estos ficheros se reutilizan de manera cíclica de modo que se van perdiendo los registros redo log que tienen una cierta antigüedad.

La Base de Datos en definitiva son son ficheros. Estos ficheros podemos identificar en ficheros de datos, ficheros de control y ficheros de Redo Log.

arquitectura_base_de_datos_oracle2


La manera que tenemos de trabajar con los datos que almacenamos en la base de datos de Oracle es a través de la instancia. La instancia es lo que permite abrir y arrancar una base de datos, cuando hablamos de arrancar la base de datos, realmente lanzamos la instancia.

Una instancia esta asociada solo a una base de datos, no es posible tener una instancia que apunte a varias base de datos.
La instancia es la encargada de acceder a  la base de datos.

Para saber la instancia de nuestra base de datos que estamos ejecutando podemos saberlo si nos conectamos a la maquina donde esta instalado el servidor Oracle y escribimos ORACLE_SID (identifica a la instancia con la que estamos trabajando).